商机详情 -
供应光学缺陷检测产品介绍
从符合标准到追求品质
在汽车发光件的质量检测中,“符合标准”只是比较低要求——产品达到规格书中规定的亮度、色度、均匀性指标,就可以判定为合格。但对于追求品牌差异化的主机厂和供应商而言,光“合格”是不够的——他们希望每一件产品都尽可能接近设计的“理想状态”。GSM1000系统提供的不单是合格/不合格的二元判定。系统输出的亮度分布、色度分布、均匀性分析结果可以帮助生产企业了解产品与理想状态的差距在哪里,从而持续改进工艺、缩小差距。这种从“符合标准”到“追求”品质,正是GSM1000系统为客户创造的更深层次的价值。 迁移学习使目标域检测准确率相比从零训练模型提升17个百分点。供应光学缺陷检测产品介绍
发光件检测与整车品质的关联
发光件虽然在整车成本中所占比例不大,但对整车品质感知的影响却很大。消费者在夜间走近一辆车时,首先注意到的是车灯和格栅灯的发光效果——亮度是否均匀、发光图案是否清晰。如果发光件存在亮度不均、色差或缺陷,会直接拉低消费者对整车品质的评价。GSM1000系统通过发光件光学性能检测,帮助生产企业确保每一件发光产品都达到设计要求的品质水平。从更宏观的视角来看,GSM1000系统所保障的不单单是发光件本身的品质,更是整车品牌在消费者心目中的品质形象。 附近哪里有光学缺陷检测维修动态迁移机制有望实现极小样本场景下的快速适配。
融合检测的实验验证数据
融合检测技术的实际效果需要通过实验数据来验证。在对比实验中,传统检测(缺陷检测用Canny+SVM,颜色检测用光谱仪)的缺陷检测准确率为68%,颜色检测误差ΔE为2.83,单件检测耗时35秒。从零训练的融合模型将准确率提升至72%,误差降至2.51,耗时缩短至12秒。而采用迁移学习的融合模型表现更为突出——缺陷检测准确率达到89%,颜色检测误差降至1.78,单件检测耗时缩短至8秒。这一组数据清晰地展示了融合检测和迁移学习带来的双重提升:融合流程将检测效率提升了4倍以上,迁移学习使目标域的检测准确率比从零训练模型提升了17%。这些数据为融合检测技术的实际应用提供了有力的支撑。
分布偏移与小样本适应性
新车型发光件的材质变化会导致数据分布发生偏移。以旧车型数据构成的源域包含1000张以上的图像,缺陷与颜色特征分布已经相对稳定;而新车型数据构成的目标域样本量通常不超过50张,特征分布与源域存在差异——例如哑光材质的反光强度可能比原有材质降低60%。这种分布偏移意味着直接在目标域上应用源域模型会产生较大的误差。迁移学习通过参数迁移和分布对齐两个机制来解决这一问题。参数迁移是指冻结源域模型的底层卷积层参数(这些参数提取的是通用的视觉特征),只微调顶层全连接层。 发光件的颜色均匀性与缺陷状态共同决定其外观等级。
深度学习模型的自动缺陷分类
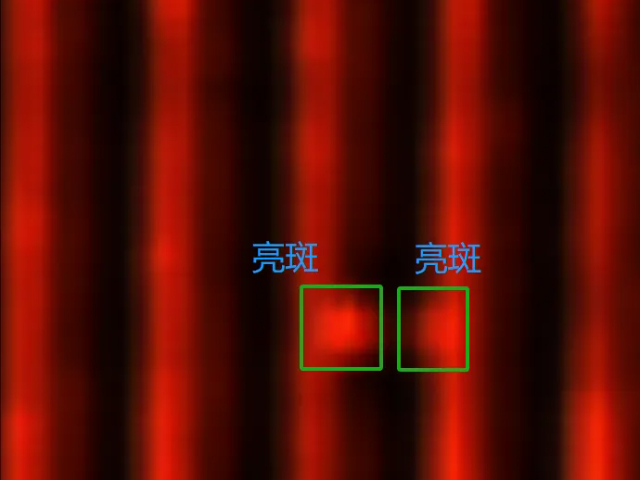
传统的缺陷检测依赖人工设定的规则和阈值——亮度超过某个值判定为亮斑、边缘梯度超过某个值判定为划痕。这种基于规则的方法在面对复杂多变的缺陷形态时往往力不从心——同一种缺陷在不同光照条件下可能呈现完全不同的外观。GSM1000系统采用基于深度学习的自动缺陷分类方法。系统通过大量缺陷样本的训练,让深度学习模型自动学习各类缺陷的视觉特征,无需人工设定规则。训练完成后,模型能够自动识别和分类各类缺陷,识别准确度高。更重要的是,模型可以通过动态更新的判定标准库持续优化,实现全生产线检测标准的统一,消除人工检测中存在的主观判断差异。 融合方案通过置信度加权实现综合质量判定,判定逻辑更完整。总成光学缺陷检测对比
传统机器学习模型因数据稀疏,在新车型上泛化能力明显下降。供应光学缺陷检测产品介绍
从单任务到多任务的演进路径
汽车发光件检测技术的发展经历了一个清晰的演进路径。单一任务检测——只关注缺陷或只关注颜色,各自使用专门的设备和算法。随后发展到多设备并行——缺陷检测和颜色检测各自运行,但共用同一个工位或同一条产线。再进一步是数据层面的融合——将两类检测数据汇总到同一个数据库中进行分析。GSM1000系统的则是更高层次的融合——模型层面的融合。在统一的深度学习模型中同时完成缺陷识别和颜色评估两个任务,让模型在学习过程中能够捕捉到两类特征之间的关联。这一演进路径反映了行业对检测精度和效率的持续追求,也体现了人工智能技术在工业检测领域应用的不断深化。
供应光学缺陷检测产品介绍