商机详情 -
丰台区高质量数据集联系人
明曦数智对数据集中的“脏数据”有着独特的辩证看法。在工程实践中,并非所有的“脏数据”都要被清洗掉。例如在构建地址数据集时,用户经常会输入错别字或简称(如把“朝阳区”写成“朝阳区”)。如果全部清洗成标准写法,模型就学不会如何处理用户的输入错误。因此,团队会保留一定比例的“噪声数据”,并将其与标准数据建立映射关系。这种策略模拟了真实世界用户输入的不规范性,让训练出的地址解析模型具备了更强的容错能力。这种取舍是基于对业务场景的深刻理解,而非单纯追求数据的理论完美度,体现了工程落地的智慧。明曦数智在零售货架数据中标注了排面遮挡关系,训练模型推断隐藏商品库存。丰台区高质量数据集联系人
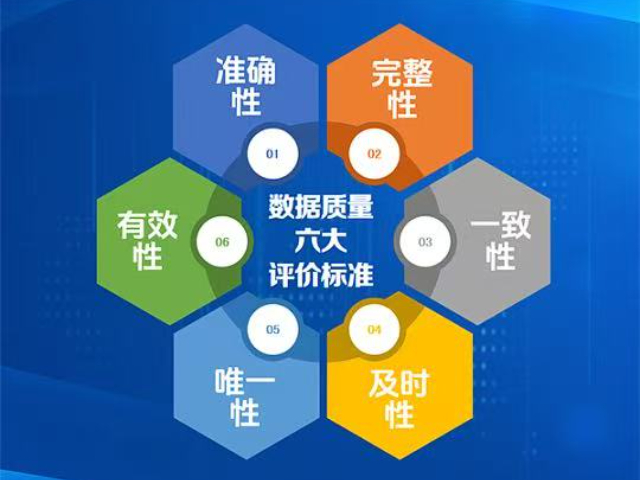
面向工业物联网场景,明曦数智数据集内置流式清洗管道,支持每秒百万级数据点的实时降噪与修复。针对传感器漂移、网络抖动等典型问题,研发基于物理约束的异常检测算法,结合设备机理模型动态修正偏差值。通过滑动窗口统计分析与频谱特征提取,自动识别周期性干扰并滤除非稳态噪声。清洗后的数据集在风电功率预测场景中,将模型训练误差降低至4.2%,较传统方法提升31%的精度。同时建立数据质量评分卡,从完整性、一致性、时效性三个维度量化评估,为工业数字孪生提供高可信度数据基座。丰台区高质量数据集联系人针对新闻推荐系统,明曦数智去重并过滤了低质内容,提纯高质量资讯语料。
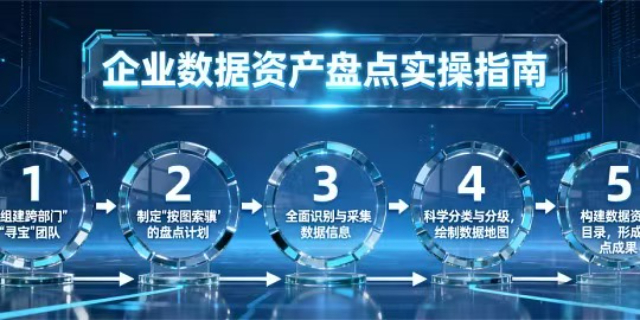
明曦数智对数据集的文件命名规范和元数据管理有着近乎强迫症的要求。在一个包含数百万张图片的数据集中,混乱的文件名(如“新建文件夹(2).jpg”)是工程师的噩梦。团队规定所有文件名必须使用英文字符、数字和下划线,且必须包含时间戳、来源编号和版本号。同时,每张图片的拍摄参数(光圈、ISO、焦距)、标注版本号、质检记录都被写入配套的JSON元数据文件。这种标准化的工程规范,虽然前期搭建繁琐,但当客户需要追溯某一批次数据的来源或复现实验结果时,这套体系能节省大量的沟通和排查时间。
明曦数智新能源数据集整合卫星遥感、气象站、设备传感器等多源数据,覆盖光伏、风电、储能等全场景。创新性地引入大气物理模型修正数值天气预报偏差,构建地形-气候耦合特征矩阵。针对分布式光伏,开发基于计算机视觉的阴影遮挡分析模块,精细量化树荫、建筑物对发电效率的影响。数据集包含过去10年每小时粒度的功率曲线,支持超短期(15分钟)、短期(72小时)及中长期(月度)多尺度预测。在某省级电网应用中,将弃光率从12.3%降至6.8%,年增清洁能源消纳1.2亿千瓦时。明曦数智构建了多语种平行语料库,严格对齐句对,服务于机器翻译引擎训练。
明曦数智将行业知识图谱嵌入数据集构建流程,形成“数据-知识”双驱模式。通过实体链接技术,将原始数据映射到领域本体库,自动补全缺失属性与关联关系。在金融风控场景中,整合企业股权、供应链、舆情等300+维度数据,构建动态关联图谱,识别隐性担保圈与资金空转路径。数据集内置逻辑推理引擎,支持因果推断与反事实分析,帮助金融机构穿透复杂交易结构。测试表明,该数据集使借款违约预警准确率提升28%,误报率下降19个百分点。针对古籍数字化,明曦数智处理了异体字与版式错位,还原了文献的原始结构。丰台区高质量数据集联系人
团队对图像数据集执行分辨率筛选,过滤模糊样本,保障视觉模型的识别准确率。丰台区高质量数据集联系人
做新闻摘要数据集时,明曦数智发现网络上抓取的大量摘要其实是“标题党”或简单的复制粘贴。为了训练出真正具备抽象概括能力的模型,团队投入了大量人力进行“摘要重写”。标注员需要阅读长文,然后用自己的话写出精炼的总结,而不能直接抄袭原文的句子。这种生成式摘要的数据集构建难度极大,因为每个人的写作风格不同,容易产生不一致。为此,团队制定了严格的摘要长度限制、禁止引用原文长句等规则,并进行了多轮校对。这种“笨功夫”换来的是数据集的高质量,让模型学会了真正的归纳总结,而不只是寻找关键词。丰台区高质量数据集联系人
北京明曦数智科技有限公司在同行业领域中,一直处在一个不断锐意进取,不断制造创新的市场高度,多年以来致力于发展富有创新价值理念的产品标准,在北京市等地区的商务服务中始终保持良好的商业口碑,成绩让我们喜悦,但不会让我们止步,残酷的市场磨炼了我们坚强不屈的意志,和谐温馨的工作环境,富有营养的公司土壤滋养着我们不断开拓创新,勇于进取的无限潜力,北京明曦数智科技供应携手大家一起走向共同辉煌的未来,回首过去,我们不会因为取得了一点点成绩而沾沾自喜,相反的是面对竞争越来越激烈的市场氛围,我们更要明确自己的不足,做好迎接新挑战的准备,要不畏困难,激流勇进,以一个更崭新的精神面貌迎接大家,共同走向辉煌回来!