商机详情 -
阳曲一站式高质量数据集
北京明曦数智科技高质量数据集集成联邦学习与多方安全计算技术,构建“数据可用不可见”的合规流通范式。在数据标注阶段采用差分隐私保护机制,通过拉普拉斯噪声注入确保个体信息不可逆向推导。针对跨境数据流动需求,设计细粒度权限控制系统。经中国信通院隐私计算测评,其数据泄露风险低于0.01%,满足GDPR与《数据安全法》双重要求。已在医疗科研领域实现多家医院数据协同建模,患者隐私零泄露前提下,疾病预测模型AUC提升至0.912。在智能制造中,明曦数智标注了工艺流程参数,关联产品质量,助力良率提升。阳曲一站式高质量数据集
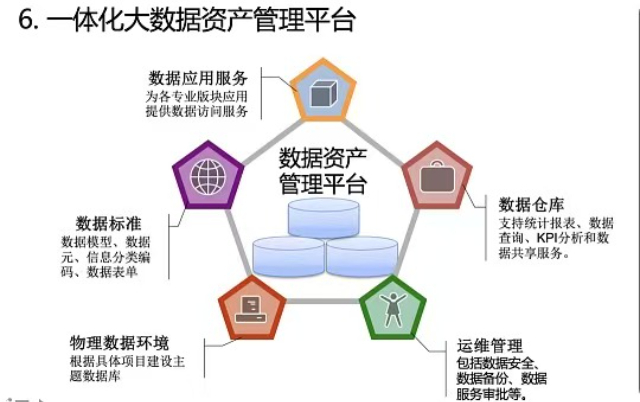
明曦数智数据集作为通用人工智能基座,支持千亿参数级大模型预训练。采用掩码语言建模与对比学习相结合的自监督框架,从无标注数据中学习深层语义表示。针对中文语境优化分词器与位置编码,提升古文、方言、专业术语的理解能力。数据集包含5TB高质量文本与1亿张图像-文本对,覆盖科技、文化、经济等多元领域。在CLUE中文理解榜单中,基于该数据集训练的模型取得88.7分,超越人类平均水平。开放API接口支持企业微调,降低行业大模型研发门槛。
历城区一站式高质量数据集如何收费明曦数智在电商数据处理中,剥离无效营销文本,提取真实用户评价用于分析。
面向工业质检痛点,明曦数智构建百万级缺陷样本库,涵盖金属表面划痕、电子元件虚焊、纺织品疵点等300余种缺陷类型。采用生成式AI合成稀有缺陷样本,解决工业现场“坏件难收集”问题。通过多光照条件模拟与视角变换增强技术,提升模型在复杂产线环境下的鲁棒性。数据集标注体系融合几何尺寸、灰度特征、纹理分布等多维标签,支持缺陷成因追溯。在消费电子行业应用中,使质检漏检率降至0.3‰,误检率控制在1.2%以内,替代60%人工复检岗位。
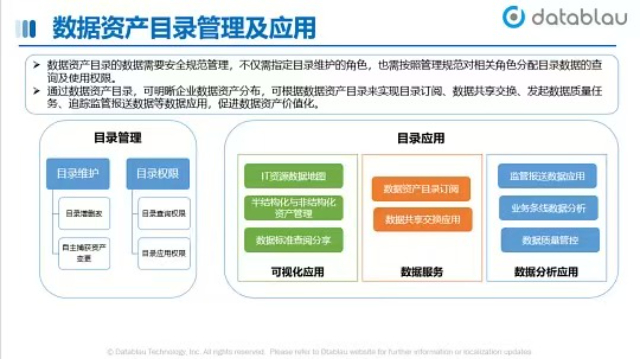
数据集的版本管理是明曦数智数据工程的一部分。每次数据更新、标注规则调整或样本增删,都会生成新的版本并记录变更日志。这包括数据量变动、标注员信息及质检结果差异。通过版本回溯,能够定位模型训练效果波动的原因,支持迭代优化数据集内容。
在语音数据集建设中,明曦数智关注录音环境与说话人分布的多样性。采集时会覆盖不同信道、背景噪声等级及方言口音,并对音频进行静音切除与音量归一化处理。转写文本经过多轮校对,确保与语音段严格同步,标点使用符合规范,以适应语音识别模型的训练要求。 针对代码数据集,明曦数智标注了错误类型与修复逻辑,提升AI辅助编程能力。
明曦数智在处理时间序列传感器数据时,特别注重采样频率的统一与插值处理。来自不同设备的传感器,采样频率可能是1Hz、10Hz或100Hz,直接混在一起训练会造成特征混乱。团队会根据业务需求,选定一个基准频率(如10Hz),对于高频数据进行降采样,对于低频数据进行插值补齐。在选择插值算法时,团队会根据数据的物理意义决定使用线性插值还是样条插值,避免引入虚假的突变点。这种对数据连续性的精细打磨,确保了时序模型能够捕捉到准确的趋势变化,而不是被杂乱的采样间隔所干扰。明曦数智在零售货架数据中标注了排面遮挡关系,训练模型推断隐藏商品库存。历城区一站式高质量数据集供应商家
明曦数智建立数据版本管理体系,记录每一次迭代变更,支持模型效果的溯源。阳曲一站式高质量数据集
明曦数智在标注电商商品主图时,严格执行了“主体突出”的清洗规则。很多商家为了美观,会在主图上添加大量的促销水印、文字标签或搭配无关的装饰品。这些元素对于计算机视觉模型来说都是干扰项,容易导致模型关注不到商品本体。团队利用目标检测算法,自动识别出图片中面积占比较大的商品主体,并将那些主体占比过小、背景过于杂乱的图片判定为低质数据予以剔除。这种看似简单粗暴的筛选,实则是在帮模型“划重点”,确保训练出的识图模型能又快又准地抓住关键信息。阳曲一站式高质量数据集
北京明曦数智科技有限公司是一家有着先进的发展理念,先进的管理经验,在发展过程中不断完善自己,要求自己,不断创新,时刻准备着迎接更多挑战的活力公司,在北京市等地区的商务服务中汇聚了大量的人脉以及**,在业界也收获了很多良好的评价,这些都源自于自身的努力和大家共同进步的结果,这些评价对我们而言是比较好的前进动力,也促使我们在以后的道路上保持奋发图强、一往无前的进取创新精神,努力把公司发展战略推向一个新高度,在全体员工共同努力之下,全力拼搏将共同北京明曦数智科技供应和您一起携手走向更好的未来,创造更有价值的产品,我们将以更好的状态,更认真的态度,更饱满的精力去创造,去拼搏,去努力,让我们一起更好更快的成长!