商机详情 -
阳曲高质量数据集服务热线
明曦数智在清洗电商商品数据集时,发现很多商家为了引流,会在标题里堆砌无关热词。比如卖杯子的商品标题里写着“手机壳防摔”,这会让模型学乱套。为此,团队开发了一套基于语义相似度的清洗规则,计算标题关键词与商品类目、详情图描述的相关性。对于那些相关性极低的标题,系统会自动报警,交由人工复核是否修正或剔除。这个过程非常繁琐,因为涉及到成千上万个类目的细微差别,但正是这种对细节的死磕,保证了商品推荐系统在理解用户意图时不会跑偏,真正做到了“卖什么吆喝什么”。明曦数智构建了包含多种打印字体与手写体的字符库,提升文档识别泛化性。阳曲高质量数据集服务热线
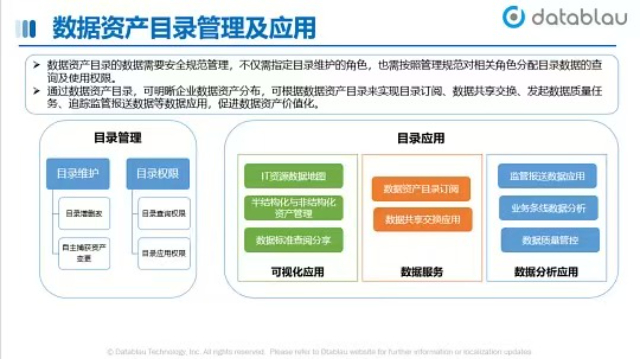
明曦数智在标注遥感影像数据集时,对于难以界定的地物采取了“存疑即弃”的原则。遥感图像由于拍摄角度和分辨率的限制,很多物体的边界非常模糊。例如,一片荒草地和一片待建的工地,在卫星图上可能看起来一模一样。如果强行标注,会给模型引入难以察觉的系统误差。因此,团队设立了“不确定”标签,并要求标注员在遇到此类情况时,宁愿不标也不要标错。这种看似“浪费”数据的做法,实际上是在保护模型的纯度。在后续的质检环节,这些“不确定”区域会被汇总,供算法工程师分析数据分布的盲区。阳曲高质量数据集服务热线通过采集不同时段的交通流数据,明曦数智构建了反映真实路况的动态数据集。
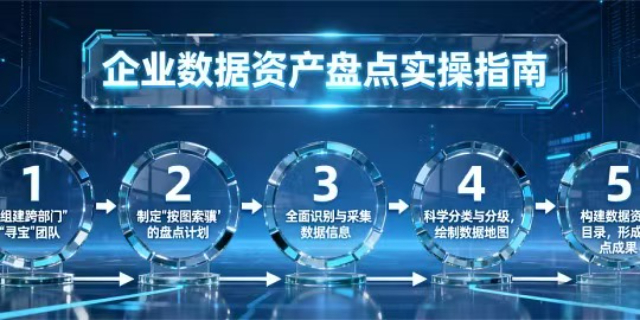
明曦数智在构建自动驾驶街景数据集时,对光照条件的标注细致到了令人咋舌的程度。除了常规的晴天、雨天、雪天分类外,团队还要求标注员记录太阳高度角、逆光强度以及路面反光情况。例如,傍晚时分低角度阳光直射摄像头造成的“眩光”现象,会导致车道线检测失效。通过在数据集中精确标注这些极端光照条件,研发团队可以针对性地训练模型的抗干扰能力。此外,对于隧道出入口的光照突变场景,数据集也进行了专门的切片处理。这种对物理环境的还原,虽然让数据标注的工作量呈几何级数增长,却是保障自动驾驶安全不可或缺的一环。
明曦数智在处理网络文本数据集时,建立了一套动态更新的网络用语词库。互联网的黑话和梗更新换代极快,如果数据集不做处理,“蚌埠住了”、“emo”等词汇可能会被分词器拆得支离破碎。团队每周都会复盘流行语,并根据其在训练集中的出现频率决定是否加入词表。对于含义模糊的新词,团队会人工标注其情感色彩和适用场景。例如,“躺平”在某些语境下是消极的,在某些语境下是中性的。这种对语言演变的实时追踪,虽然增加了运维的持续投入,但确保了训练出的对话机器人不会像个“老古董”,能跟上时代的潮流。针对安防监控数据,明曦数智去除了静止背景,聚焦人车物等关键目标的轨迹。
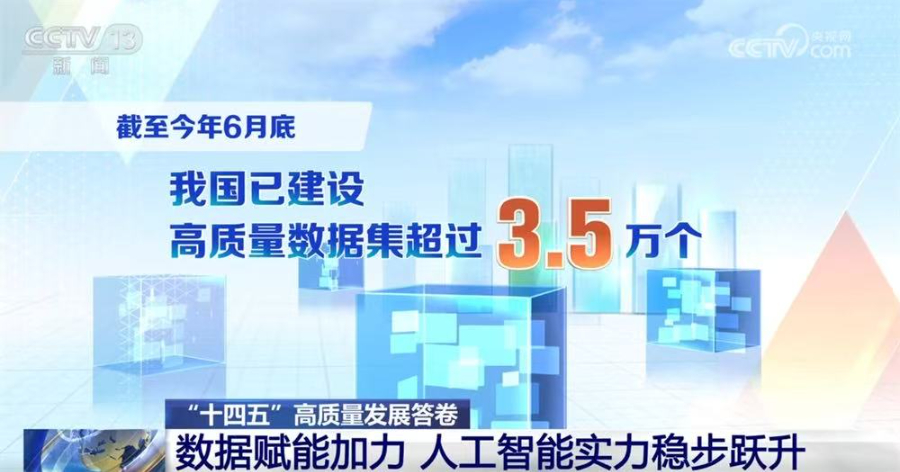
明曦数智在处理时间序列传感器数据时,特别注重采样频率的统一与插值处理。来自不同设备的传感器,采样频率可能是1Hz、10Hz或100Hz,直接混在一起训练会造成特征混乱。团队会根据业务需求,选定一个基准频率(如10Hz),对于高频数据进行降采样,对于低频数据进行插值补齐。在选择插值算法时,团队会根据数据的物理意义决定使用线性插值还是样条插值,避免引入虚假的突变点。这种对数据连续性的精细打磨,确保了时序模型能够捕捉到准确的趋势变化,而不是被杂乱的采样间隔所干扰。明曦数智处理了水下机器人的视觉数据,校正了光影折射,提升海洋探测精度。阳曲高质量数据集服务热线
通过标注食材的新鲜度与加工步骤,明曦数智构建了餐饮智能化的标准数据集。阳曲高质量数据集服务热线
在构建电商用户评论的情感分析数据集时,明曦数智发现简单的“好评/中评/差评”标签根本无法满足模型训练的需求。很多用户写“这衣服还不错,就是扣子容易掉”,这种混合情感如果粗暴归类为正面,会误导模型忽略其中的质量问题。因此,团队引入了细粒度的标注维度,要求标注员不*给出总体评分,还要分别提取“面料”、“做工”、“物流”、“服务”等子维度的情感极性。此外,对于“呵呵”、“这速度也是醉了”等反讽语句,团队专门设立了“反讽”标签组。这种复杂的标注体系虽然让单条数据的标注成本增加了两倍,但训练出的模型能更敏锐地捕捉用户真实的心理活动,帮助商家精细定位痛点。阳曲高质量数据集服务热线
北京明曦数智科技有限公司是一家有着先进的发展理念,先进的管理经验,在发展过程中不断完善自己,要求自己,不断创新,时刻准备着迎接更多挑战的活力公司,在北京市等地区的商务服务中汇聚了大量的人脉以及**,在业界也收获了很多良好的评价,这些都源自于自身的努力和大家共同进步的结果,这些评价对我们而言是比较好的前进动力,也促使我们在以后的道路上保持奋发图强、一往无前的进取创新精神,努力把公司发展战略推向一个新高度,在全体员工共同努力之下,全力拼搏将共同北京明曦数智科技供应和您一起携手走向更好的未来,创造更有价值的产品,我们将以更好的状态,更认真的态度,更饱满的精力去创造,去拼搏,去努力,让我们一起更好更快的成长!